Le traitement IA sur FPGA permet de mieux localiser les particules
Un réseau de neurones convolutif implémenté sur le FPGA du numériseur de Teledyne SP Devices permet de bien localiser chaque particule du faisceau de l'accélérateur du GSI.
www.spdevices.com
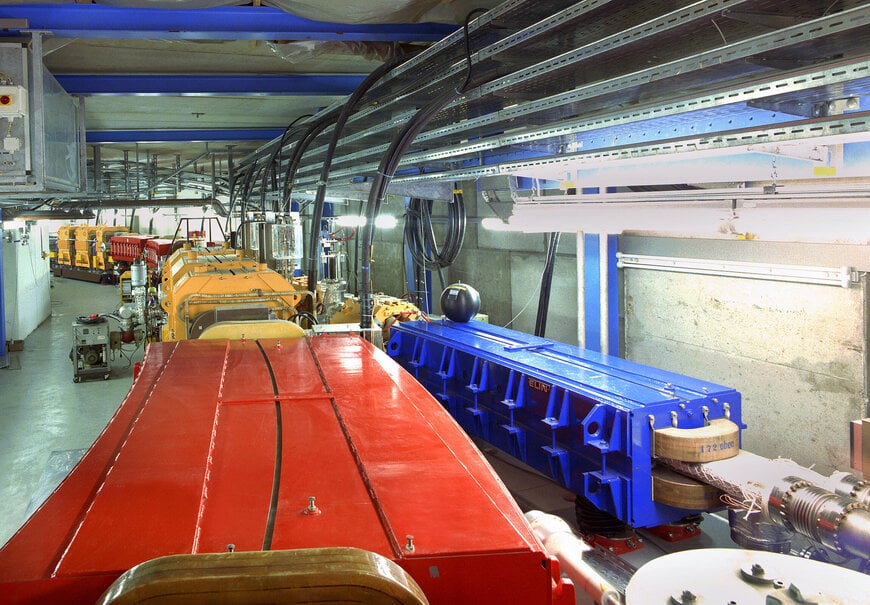
L’inférence IA, réalisée sur le FPGA du numériseur de la gamme ADQ35 de Teledyne, permet de localiser de manière fiable et précise les particules en temps réel au GSI Helmholtzzentrum für Schwerionenforschung à Darmstadt, en Allemagne, avec une latence inférieure à la microseconde et une résolution temporelle inférieure à la nanoseconde, même à des taux de particules élevés et en présence d’un chevauchement important des signaux. Ces travaux ont été menés dans le cadre d’une recherche doctorale à l’Université des sciences appliquées de Fulda en collaboration avec le GSI. Un réseau neuronal convolutif (CNN) implémenté directement sur le FPGA traite 120 Gbits de données par seconde avec une latence de seulement 300 ns.
Compter chaque particule dans le spill
Les accélérateurs de particules produisent des faisceaux de particules contrôlés avec précision pour les expériences scientifiques, la recherche sur les matériaux et les applications médicales. Au GSI, le synchrotron SIS18 accélère les particules dans l’anneau puis dirige son faisceau vers les expériences en extrayant les particules du faisceau, selon un processus appelé « spill ». Pour contrôler le spill, il est essentiel de connaître le nombre de particules qu’il contient et leur répartition dans le temps. Pour ce faire, chaque particule du spill doit être localisée en temps réel pendant le fonctionnement de l’accélérateur, ce qui constitue un défi majeur pour l’instrumentation des faisceaux des accélérateurs de particules.
Un détecteur est placé sur le faisceau et émet une impulsion pour chaque particule qui le traverse. Ce phénomène est illustré à la Figure 1. Lorsque plusieurs particules traversent le détecteur dans un intervalle de temps très court, les impulsions se chevauchent et la réponse du détecteur peut devenir non linéaire. Ce chevauchement des impulsions est appelé « pile-up », et sa probabilité augmente avec l’intensité du faisceau. Lorsque les événements de pile-up ne peuvent pas être correctement résolus, ils doivent être évités, ce qui limite l’intensité du faisceau.
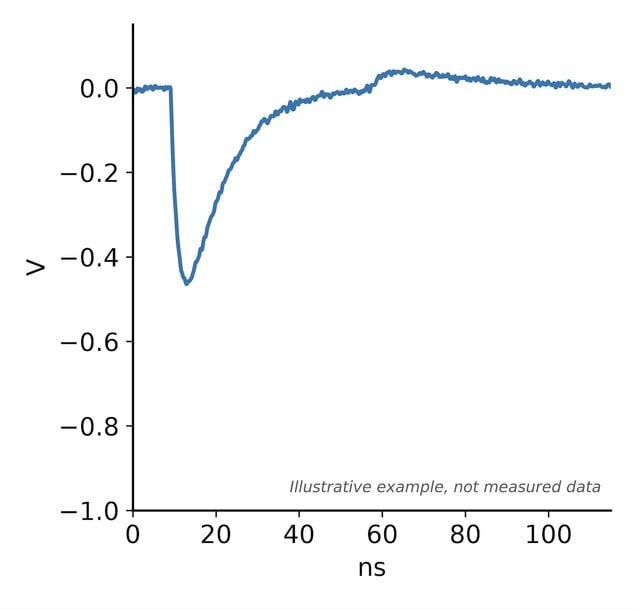
Figure 1. L’impulsion générée lorsqu’une particule atteint le détecteur.
La Figure 2 présente quatre exemples de ce phénomène de pile-up. Chaque exemple montre la réponse du signal lorsque trois particules arrivent dans un intervalle de temps très court. Le temps d’arrivée de chaque particule est indiqué par une ligne pointillée verte.
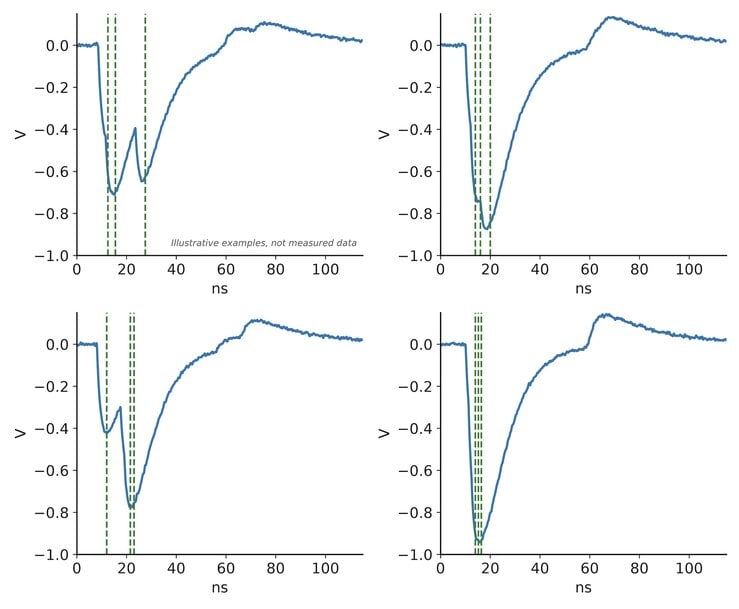
Figure 2. La réponse du détecteur lorsque plusieurs particules arrivent dans un intervalle de temps très court. Trois particules arrivent et leurs impulsions se chevauchent.
Les méthodes traditionnelles, telles que la détection multi-seuils ou la recherche de maxima locaux, peinent à détecter les particules lorsque du pile-up se produit et échouent souvent. Cela entraîne un sous-comptage susceptible de compromettre le contrôle du spill et les expériences réalisées en aval.
Traitement du signal par IA sur FPGA
Pour relever ce défi, un CNN a été développé et entraîné sur des données annotées. Il a ensuite été implémenté directement sur un FPGA à l’aide d’une chaîne d’outils développée par UFAIRA.
Le modèle d’IA localise chaque impulsion individuellement, même en présence de pile-up, et extrait en temps réel à la fois le nombre de particules et les informations relatives à leur temps d’arrivée. Cette approche permet de reconstruire avec précision le spill, même à des taux très élevés. L’implémentation du CNN sur FPGA traite les données en ligne et garantit une latence déterministe, ce qui est particulièrement important pour les applications en temps réel telles que le contrôle du spill.
Implémentation sur le numériseur
La solution repose sur le numériseur haute vitesse de la gamme ADQ35 de Teledyne SP Devices, avec des fréquences d’échantillonnage pouvant atteindre 10 Gech/s et un FPGA AMD Kintex UltraScale KU115 embarqué. Celui-ci offre d’importantes ressources de calcul pour effectuer l’inférence IA en temps réel directement sur le numériseur. Le traitement des données directement sur le numériseur permet d’éviter les goulots d’étranglement liés au transfert des données et d’atteindre une latence inférieure à la microseconde.
Grâce à une chaîne d’outils destinée à l’entraînement et à l’implémentation du CNN, optimisée pour les FPGA et tenant compte des contraintes matérielles, le CNN implémenté peut traiter 32 échantillons en parallèle à 312,5 MHz, ce qui permet d’atteindre 10 Géch/s, avec une latence faible et déterministe ainsi qu’une grande précision.
Une latence de 300 ns à 120 Gbit/s
Le CNN implémenté atteint une latence de seulement 300 ns et traite 120 Gbits/s (10 Géch/s, avec 12 bits par échantillon). Il utilise moins de 15 % des ressources DSP disponibles et moins de 6 % des ressources LUT disponibles sur le FPGA, laissant ainsi suffisamment de ressources pour des modèles encore plus importants ou pour viser un débit supérieur.
L’approche fondée sur l’IA améliore considérablement les performances en présence de pile-up et surpasse les méthodes traditionnelles telles que la détection multi-seuils et la recherche de maxima locaux. Le CNN localise les impulsions individuelles lors des événements de pile-up avec une telle fiabilité qu’il n’est plus nécessaire d’éviter le pile-up en réduisant le taux de particules. Le système peut ainsi fonctionner à des taux de particules beaucoup plus élevés sans nécessiter de modifications du matériel du détecteur lui-même.
Utilité de l'IA pour le traitement de données haute vitesse
Cet exemple montre que l’IA devient particulièrement pertinente lorsque plusieurs événements se produisent sur une même période et génèrent un signal superposé. Elle peut également être utile lorsque le traitement du signal est trop complexe pour les méthodes traditionnelles ou lorsque la forme des signaux varie en raison d’effets réels tels que la dérive, le bruit et la non-linéarité. Les modèles d’IA peuvent apprendre des comportements complexes des signaux et extraire en temps réel des informations difficiles, voire impossibles, à récupérer avec les méthodes traditionnelles.
L’approche présentée ici est largement applicable aux domaines de données haute vitesse nécessitant un traitement en ligne à faible latence, notamment la surveillance de spectre en temps réel et la classification de signaux, l’estimation de canal dans les systèmes RF, le trading haute fréquence, la détection des intrusions réseau, le traitement d’images pour les systèmes autonomes, et bien plus encore.
À propos d’UFAIRA
Les méthodes et la chaîne d’outils utilisées dans cette recherche constituent désormais la base d’UFAIRA, une entreprise qui développe des accélérateurs IA sur FPGA personnalisés pour l’inférence en temps réel, fondée en 2026 en tant que spin-off issue des travaux de recherche doctorale menés à l’Université des sciences appliquées de Fulda.
www.spdevices.com